Qué aprendió un departamento de tecnología de 200 personas al medir la adopción de IA en desarrollo de software; caso de uso por caso de uso y por qué la productividad con IA no se resume en una sola cifra.
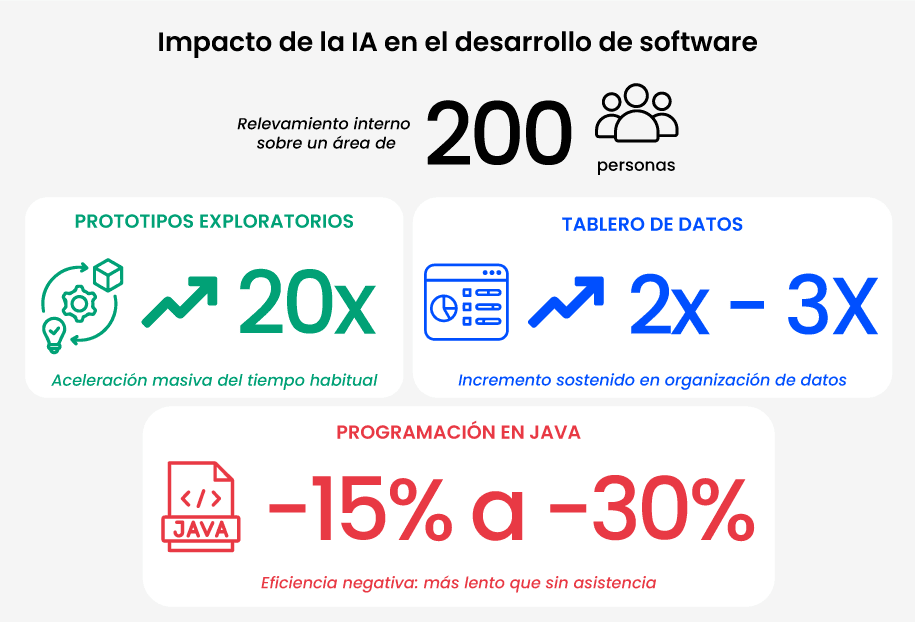
Cuando un departamento de tecnología empieza a medir el impacto de la programación asistida por IA sobre la productividad en desarrollo de software, la primera sorpresa rara vez es sobre la herramienta. Es sobre la dispersión de resultados dentro de la propia organización. En un relevamiento reciente sobre un área de aproximadamente 20 personas, la construcción de prototipos exploratorios rindió multiplicadores del orden de veinte veces sobre el tiempo habitual; la construcción de tableros para organizar datos rindió entre dos y tres veces; y la programación en Java —el lenguaje enterprise por excelencia en ese departamento— rindió con una eficiencia negativa: entre 15% y 30% más lento que sin asistencia, con código que no pasaba los casos de test y que requería corrección manual (según el relevamiento interno del Laboratorio de Innovación de 7Puentes).
Esta dispersión no es un defecto de la medición: es el hallazgo. Y coincide con lo que muestra la evidencia externa de mejor calidad disponible hasta la fecha. Un experimento controlado de METR, con developers expertos trabajando sobre sus propios repositorios maduros, midió una desaceleración del 19% en un escenario donde los propios developers habían anticipado una mejora del 24%. Son treinta y nueve puntos de distancia entre la percepción y el resultado medido.
Este artículo describe lo que ese contraste, entre el caso que multiplica por veinte y el caso que retrocede un tercio, implica para el diseño de una estrategia de adopción de IA en desarrollo de software, y qué artefactos organizacionales terminan siendo la variable que explica la diferencia.
Programación asistida por IA: no existe un multiplicador único para toda la organización
La tentación, frente a una cifra atractiva de un caso de uso, es proyectarla sobre el resto del departamento. La evidencia no lo sostiene. Cuando se filtran los estudios disponibles por calidad de evidencia (experimentos controlados primero, telemetría después, encuestas al final) el rango observado va desde −19% en código legacy mantenido por expertos hasta +21–26% en tareas acotadas de campo, medidas sobre miles de developers, según un estudio de Google con RCT enterprise y un trabajo de campo de Cui et al. El relevamiento interno del Laboratorio de Innovación reproduce ese mismo patrón puertas adentro de una sola organización: los casos de uso con tareas bien delimitadas y bajo nivel de dependencia del código existente —prototipado, tableros— rinden bien de entrada. Los casos con código productivo de larga vida, en un lenguaje con convenciones estrictas y suites de test maduras, no.
La consecuencia práctica es de diseño, no de optimismo o pesimismo: el primer entregable de cualquier programa de adopción de IA en desarrollo de software no debería ser una proyección de ahorro agregado, sino un mapa de casos de uso con su múltiplo esperado, su nivel de confianza y las condiciones que lo sostienen.
Adopción de IA en desarrollo de software: el cuello de botella no desaparece, se traslada
El hallazgo más consistente entre fuentes con intereses distintos durante el último año es que la IA acelera la generación de código y traslada la presión hacia etapas posteriores del ciclo. La telemetría de mayor escala disponible (22.000 developers, 4.000 equipos, dos años de datos, según el reporte de Faros AI) muestra un incremento del 34% en tareas completadas por developer, acompañado de un 54% más de bugs por developer, del triple de incidentes por pull request y de un tiempo de revisión multiplicado por cinco. Un 31% adicional de pull requests se mergea sin revisión alguna. El reporte de DORA llega a una conclusión equivalente por otra vía: más throughput, más inestabilidad de entrega.
El caso de Java del relevamiento interno es una instancia concreta de este mismo fenómeno: cuando el modelo no tiene acceso a las convenciones internas del código base ni a ejemplos representativos, el costo de corrección se traslada del tiempo de escritura al tiempo de revisión y reescritura, y ese costo puede superar el beneficio inicial. La analogía que usamos con los equipos es la de agrandar el motor sin tocar los frenos: sin inversión previa en revisión, tests y gates de calidad, la ganancia neta puede ser nula o negativa.
Cómo medir la productividad en desarrollo de software con IA sin autoengañarse
El error metodológico más frecuente es comparar a quienes adoptaron la herramienta contra quienes no la adoptaron. Los análisis de commits a gran escala (según la investigación de GitClear sobre usuarios intensivos y mantenibilidad) muestran que los usuarios intensivos de IA producen entre 4 y 10 veces más que los no usuarios, pero la mayor parte de esa brecha ya existía antes de la adopción: los early adopters tienden a ser, en promedio, los developers más productivos de antes. Contra su propio historial, la ganancia de los usuarios intensivos ronda el 25%.
De ahí se derivan tres reglas de medición: desconfiar de las métricas fáciles de inflar (tasa de aceptación de sugerencias, porcentaje de código generado, volumen de líneas o de pull requests, según DX); medir lo que efectivamente le importa al negocio —cycle time, tasa de fallas en producción, retrabajo a 30 días, código que sobrevive—; y respetar la curva de aprendizaje, dado que hay una caída inicial de productividad mientras el equipo se adapta, y evaluar un piloto antes de los 3 a 6 meses tiende a producir conclusiones equivocadas en cualquier dirección.}
Los artefactos que sostienen la productividad en desarrollo de software con IA, y el rol que falta
El hallazgo más útil del relevamiento del Laboratorio de Innovación, para efectos de diseño organizacional, no es ningún múltiplo puntual sino lo que distingue a los casos de uso que funcionan bien de los que no: la existencia de un conjunto de artefactos compartidos (plantillas de especificación, ejemplos de referencia, guías de estilo ejecutables) que orientan al agente antes de que produzca una línea de código. En los casos de uso de mejor rendimiento, el rol del developer se desplaza parcialmente de escribir código a producir y mantener esas plantillas.
Ese desplazamiento genera una necesidad organizacional que rara vez tiene dueño asignado: alguien tiene que sostener esos documentos actualizados a medida que el código base cambia. Es una función de gobierno de la información, no de escritura de código; lo que en 7Puentes describimos como el rol de «bibliotecario» de los artefactos que alimentan a los agentes de desarrollo. Sin ese rol, las plantillas se desactualizan, el agente vuelve a fallar en los casos donde antes rendía, y la organización tiende a concluir, de forma prematura, que la herramienta no sirve para ese tipo de tarea.
En el Laboratorio de Innovación de 7Puentes, el Canvas de Agentes y Automatización se usa precisamente para esto: mapear, caso de uso por caso de uso, qué artefactos hace falta construir y quién queda a cargo de sostenerlos en el tiempo, antes de proyectar cualquier número de productividad agregada.
Conclusión: diseñar la adopción de IA en desarrollo de software, caso por caso
La adopción de programación asistida por IA en un departamento de tecnología de escala no se resuelve con una decisión de licenciamiento. Requiere un diseño explícito: un mapa de casos de uso con múltiplos diferenciados y su nivel de confianza, compuertas de calidad avanzadas que se instalen antes que el volumen, una medición honesta contra el propio historial de la organización, y un rol claro para sostener los artefactos que hacen que la herramienta rinda donde hoy todavía no rinde.
La capacidad adicional que genera la IA, sostenida en el tiempo, es una expansión de lo que un equipo puede hacer, no un argumento para reducirlo. Desde el Laboratorio de Innovación de 7Puentes se vienen especificando programas de adopción de este tipo con la evidencia, propia y de terceros, sobre la mesa.