Las bases de datos vectoriales se convirtieron en una pieza central de la inteligencia artificial generativa (GenAI) y de los modelos de lenguaje de gran tamaño (LLM). Permiten almacenar, indexar y consultar millones de vectores en milisegundos, algo que una base relacional tradicional no puede hacer con eficiencia.
En 7Puentes trabajamos con bases de datos vectoriales en proyectos de machine learning (ML), búsqueda semántica e IA generativa. En esta guía explicamos qué son, cómo se relacionan con los embeddings y con RAG, y cuáles son los cuatro desafíos que definen si un proyecto llega a producción o se queda en prueba de concepto.
Puntos clave:
- Las bases de datos vectoriales guardan la información como vectores numéricos (embeddings) y la recuperan por similitud, no por coincidencia exacta.
- Gartner proyectó que para 2026 más del 30% de las empresas habrían adoptado esta tecnología, frente a menos del 2% en 2023.
- Algoritmos como HNSW permiten buscar vecinos cercanos entre miles de millones de vectores con baja latencia.
- El éxito de las bases de datos vectoriales depende menos de la herramienta elegida y más de la ingesta de datos, los metadatos y el tamaño del embedding.
Qué son las bases de datos vectoriales
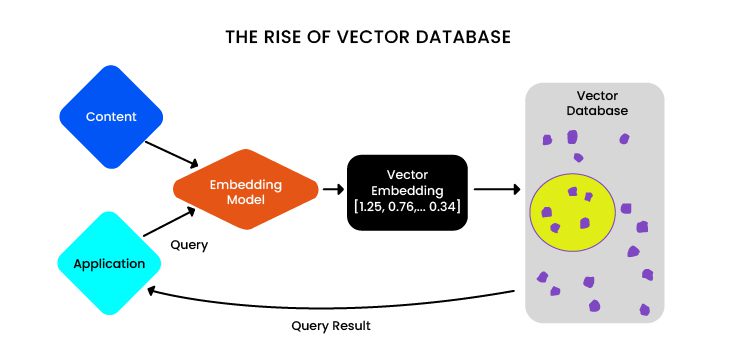
Las bases de datos vectoriales son sistemas diseñados para almacenar y buscar vectores: listas de cientos o miles de números que representan el significado de un texto, una imagen, un audio o un video. En lugar de devolver filas que coinciden con un valor exacto, devuelven los elementos más parecidos a una consulta.
Una base relacional organiza los datos en filas y columnas. Una base vectorial, en cambio, ubica cada dato como un punto en un espacio de muchas dimensiones y agrupa los puntos por cercanía. Ese diseño habilita consultas de baja latencia, ideales para aplicaciones de IA.
El cambio responde a la naturaleza de los datos actuales. La información ya no es solo estructurada: publicaciones en redes, imágenes, videos, clips de audio y documentos crecen a gran velocidad y no encajan en una tabla.
Un ejemplo cotidiano ayuda a entenderlo. Los buscadores clásicos usan índices invertidos para saber en qué documentos aparece una palabra. Las bases de datos vectoriales van un paso más allá: encuentran documentos que hablan de lo mismo aunque no compartan las mismas palabras.
Embeddings y LLM: el punto de partida
Un embedding es la representación numérica de un contenido. En reconocimiento facial, por ejemplo, el sistema no guarda la foto original: guarda una codificación de sus rasgos. Esa codificación es el vector que después se compara con otros.
Con la llegada de los LLM aparecieron embeddings genéricos, que sirven para muchas aplicaciones sin ajustes. Un modelo así puede inferir que la foto de un árbol se parece más a la de una planta que a la de una persona.
El problema surge con los casos específicos. Detectar electrodomésticos en una cadena de retail o distinguir productos electrónicos en un e-commerce exige rasgos más finos que los de un embedding genérico. Ese es el tipo de ajuste que resolvemos en proyectos de búsqueda inteligente de productos.
Tamaño del embedding versus velocidad de búsqueda
Los embeddings tienen cientos o miles de dimensiones. Encontrar qué imagen se parece a otra entre miles de millones de candidatas exige mucha capacidad de cómputo. Por eso se usan bases de datos vectoriales con algoritmos de búsqueda de vecinos más cercanos.
Los más comunes son KNN (k vecinos más cercanos) y HNSW (Hierarchical Navigable Small World), un método basado en grafos que acelera la búsqueda aproximada. La idea es simple: dado un vector, devolver los vectores más similares.
Acá aparece un equilibrio clave. Un embedding más chico abstrae más, responde rápido y es menos específico. Un embedding más grande ofrece resultados más precisos, pero tarda más y cuesta más. La decisión correcta depende siempre del caso de uso.
Filtrado híbrido: un ejemplo concreto
Supongamos que cargamos un libro extenso, como la Biblia, en un LLM y le pedimos pasajes sobre la soledad. Si el modelo debe procesar el texto completo para cada pregunta, el costo es altísimo.
La alternativa es indexar el texto por libro, capítulo y párrafo, con metadatos. Primero se filtra por la sección relevante y después se hace la búsqueda semántica sobre esos fragmentos. Eso es filtrado híbrido, y reduce el costo de cada consulta a una fracción del original.
Bases de datos vectoriales y RAG: por qué van juntas
RAG (retrieval-augmented generation, o generación aumentada por recuperación) es un enfoque que combina un sistema de recuperación de información con un LLM. Fue presentado en 2020 en un trabajo de investigadores de Meta AI y hoy es la arquitectura más usada para llevar IA generativa a datos de negocio.
En una arquitectura RAG, las bases de datos vectoriales funcionan como la memoria del sistema. Recuperan los fragmentos relevantes y el LLM redacta la respuesta con ese contexto. El resultado es un texto más preciso, actualizado y específico del dominio, con menos tokens por consulta.
Según el mismo informe de Gartner de 2023, más del 70% de los casos de preguntas y respuestas con IA generativa iban a apoyarse en bases de datos vectoriales para anclar sus modelos a datos reales. Es la lógica que aplicamos en nuestras soluciones de IA generativa.
4 desafíos de las bases de datos vectoriales en la empresa
Hoy hay muchas más pruebas de concepto que soluciones estandarizadas en producción. Estos son los cuatro desafíos que vemos con más frecuencia:
- Multimodalidad.
La base debe encontrar no solo texto, sino también imágenes, audio y video. Cada formato requiere su propio modelo de embedding y una forma coherente de combinarlos. - Modelo de negocio y tecnología.
Hay opciones 100% open source, servicios gestionados con pago por uso y bases tradicionales que sumaron búsqueda vectorial, como MongoDB o Elasticsearch. También existen motores vectoriales nativos. Elegir bien requiere una evaluación técnica y de costos, que es parte de nuestro servicio de consultoría en IA. - Ingesta de datos.
Es el punto decisivo. Si los documentos son de baja calidad o no tienen metadatos adecuados, el rendimiento cae, sin importar cuánto cueste la herramienta. Por ejemplo, cargar manuales de lavarropas, heladeras y televisores sin indicar a qué producto corresponde cada uno empobrece todas las respuestas. - Preprocesamiento y reducción de contexto.
Los LLM pueden leer documentos extensos, pero si les indicamos qué capítulos o secciones importan, responden con más precisión y a menor costo. Lo mismo vale para imágenes: el modelo tiene que distinguir con claridad un lavarropas de una heladera.
La herramienta importa, pero la calidad de los datos que entran a la base vectorial importa más. Una buena ingesta, con metadatos ricos y fragmentos bien definidos, vale más que cualquier optimización posterior.
— Equipo de Machine Learning, 7Puentes
Cómo evaluar bases de datos vectoriales para tu caso de uso
Antes de elegir una tecnología, conviene responder algunas preguntas concretas:
- Volumen y crecimiento: cuántos vectores vas a almacenar hoy y en dos años.
- Latencia: qué tiempo de respuesta necesita la aplicación final.
- Tipos de datos: solo texto o también imágenes, audio y video.
- Filtros: qué metadatos vas a usar para la búsqueda híbrida.
- Costo total: licencias, infraestructura y equipo para operarla.
Con esas respuestas, la mejor estrategia es validar rápido con un piloto acotado. En 7Puentes lo hacemos con nuestro servicio de desarrollo de MVP de IA, y luego escalamos con un Agile Data Squad dedicado.
Los mismos principios de calidad de datos aplican en otros dominios. Por ejemplo, en mantenimiento predictivo con IA, donde las señales heterogéneas de sensores son el principal obstáculo.
7Puentes: tu aliado para adoptar la tecnología correcta
En 7Puentes contamos con un equipo de especialistas en datos e IA que evalúa cada caso y recomienda la solución adecuada para gestionar los datos de tus modelos. Conocemos los límites y el potencial de las bases de datos vectoriales, y te ayudamos a pasar de la prueba de concepto a un sistema en producción.
Preguntas frecuentes
¿Cuál es la diferencia entre una base de datos vectorial y una relacional?
Una base relacional guarda datos en filas y columnas y busca coincidencias exactas. Una base de datos vectorial guarda embeddings y busca por similitud, lo que permite encontrar contenidos relacionados aunque no usen las mismas palabras.
¿Qué es HNSW y por qué es tan usado?
HNSW (Hierarchical Navigable Small World) es un algoritmo basado en grafos para búsqueda aproximada de vecinos cercanos. Es muy usado porque ofrece un buen equilibrio entre velocidad y precisión en colecciones de millones o miles de millones de vectores.
¿Necesito una base de datos vectorial para implementar RAG?
En la mayoría de los casos, sí. RAG necesita recuperar rápido los fragmentos más relevantes para cada pregunta, y las bases de datos vectoriales están diseñadas para eso. En proyectos muy chicos puede alcanzar con una búsqueda en memoria, pero no escala.
¿Qué base de datos vectorial conviene elegir?
Depende del volumen, la latencia requerida, los tipos de datos, los filtros por metadatos y el costo total. Recomendamos evaluar dos o tres opciones con un piloto sobre datos reales antes de decidir.